ハードウェア / GPU・VRAMの購入判断
32GB VRAMは本当に必要?AI用途で12GB・16GB・24GB・32GBをどう選ぶか
AI制作の設定を残したいなら、必要なVRAMからGPUを選ぶと候補を絞れます。24GBに収まる処理にはRTX 3090、24GBを超える処理には32GBのRTX 5090が具体的な比較候補です。容量・速さ・対応ソフトを分けて、用途に合う購入先まで整理します。
広告:この記事にはアフィリエイトリンクが含まれます。リンク経由の購入・申込みにより、Noverunaに報酬が入る場合があります。
運営者の利用状況
12GBを2枚持っていても、1枚の24GBにはならない
Noveruna運営者は、RTX 4070 Ti 12GBとRTX 3060 12GBを使っています。用途はComfyUI、AI画像生成、AI動画生成、ローカルLLM。実際にVRAM不足を経験し、V100、Quadro GV100、RTX 3090、RTX 5090などを購入候補として比較してきました。
ここで共有できるのは、現在の機材と用途、不足した経験までです。候補の32GB GPUを所有して測った生成時間や消費電力はありません。以下の容量別の説明も、運営者が各容量を実測した比較ではありません。
12GBのGPUが2枚あっても、通常の単一GPU向け処理が自由に使える24GBの領域ができるわけではありません。モデルを分けて配置するには、実行ソフト側の対応と設定が要ります。この仕組みはマルチGPUと容量表記の落とし穴で図解します。
Noverunaの判断・確認手順
容量の差は、設定をどこまで保てるかに表れる
同じ「画像生成」でも、モデル、重みの精度、解像度、同時生成枚数、追加モデルの数で必要量は変わります。「動画なら32GB」「LLMなら24GB」と用途名だけで線を引くことはできません。次の目安は、購入前の確認順です。
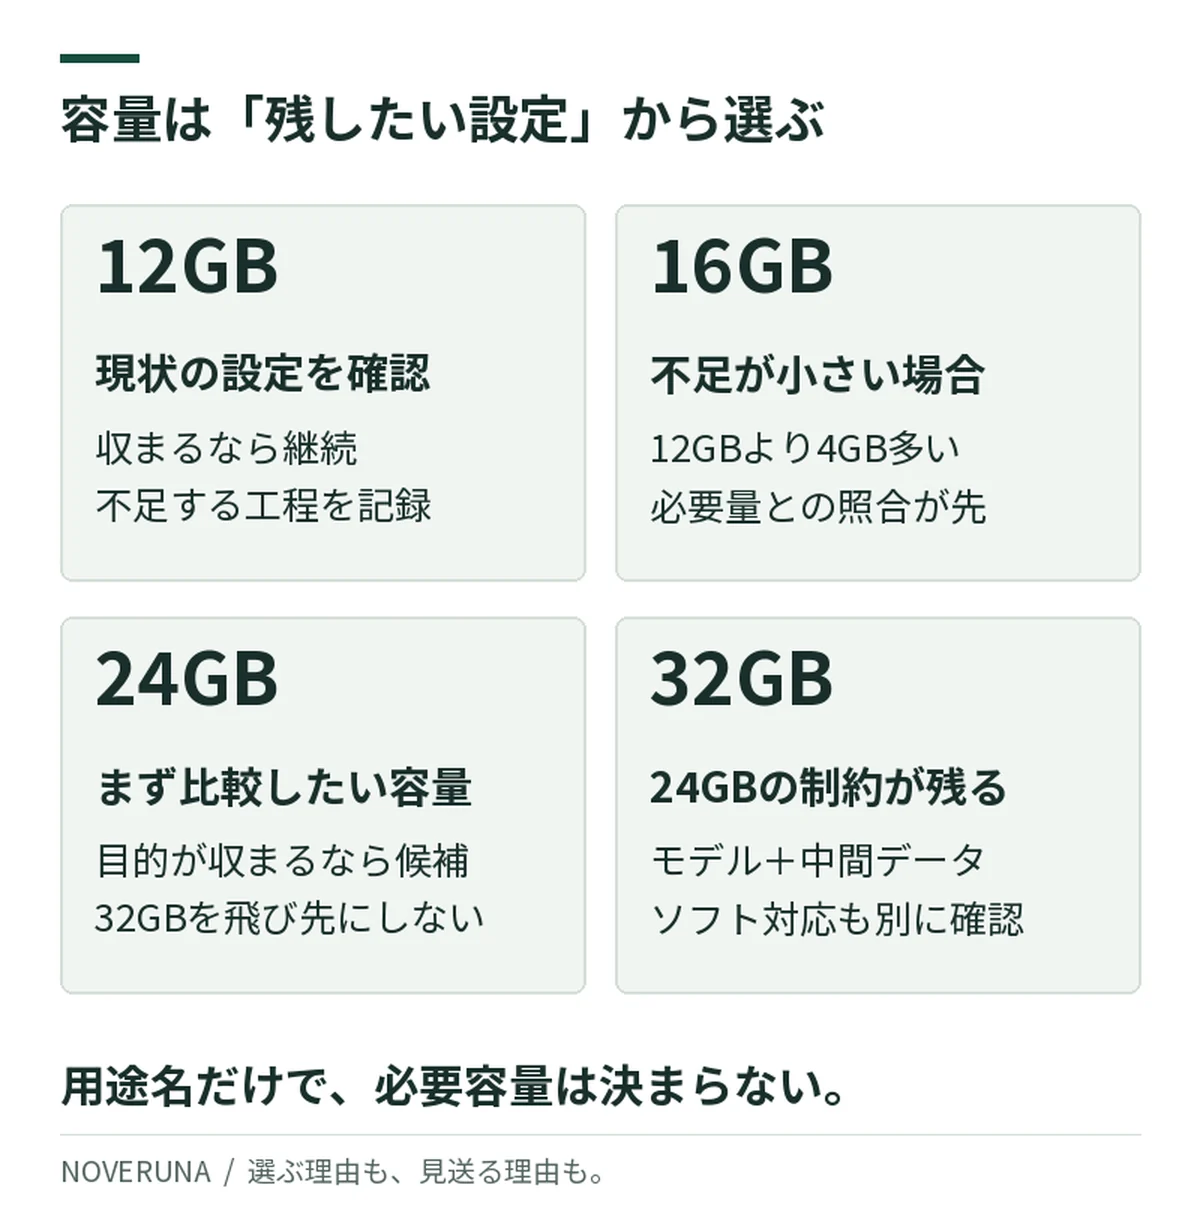
図の要点を文章で読む
- 12GB:必要な設定で処理が収まるなら継続。不足するなら、止まる工程を記録します。
- 16GB:12GBより4GB多い容量です。その差で不足を解消できるかを先に確認します。
- 24GB:32GBの前に比較する容量。目的の処理が収まるなら購入候補になります。
- 32GB:24GBの制約が残る場合に検討。容量と、使うソフトへの対応を別々に確認します。
12GB:いまの処理を見直す出発点
使いたいワークフローが収まり、待ち時間も許容できるなら現状維持。画像を1枚ずつ生成する、対応する軽量モデルを選ぶ、動画の解像度やフレーム数を下げるなど、削ってよい条件を先に決めます。
16GB:12GBを少し超える不足に
12GBからの余裕は4GBです。必要量がその範囲に収まる見通しがあるかを確認します。容量を少し増やしても、演算性能が下がれば処理時間は長くなる可能性があります。
24GB:32GBの前に比較したい容量
目標の設定を保ったまま収まるなら、有力な到達点です。RTX 3090の公称容量も24GB。状態・電源・保証と、目的のソフトへの対応を含めて比較します。
32GB:24GBの制約が具体的なときに
モデルや同時常駐する構成、LLMの文脈長などで24GBの壁が残る場合に検討。32GBを超える処理や非対応の演算を、容量だけで解決することはできません。
メモリ表示のGBとGiB、OSや画面表示が使用する分、実行時に確保される作業領域にも差があります。公称容量の最後までモデル本体を詰め込める前提では選ばない方がよいでしょう。
出典・確認先:NVIDIA GeForce RTX 3090 / 3090 Ti公式仕様、Hugging Face Diffusers:メモリ使用量を減らす(2026-09-11確認)。
Noverunaの判断・確認手順
32GBが効くのは「重み以外」も載せたいとき
ComfyUI・画像生成:完成したワークフローを基準にする
単体モデルの読み込みに成功しても、追加の制御モデル、アップスケール、VAEデコードまで完走するとは限りません。最初の生成だけでなく、普段使う最後の工程まで含めて、どこでメモリ不足になるかを記録します。目的のモデルの公式手順と、そのワークフローに使うノードの要件を優先してください。
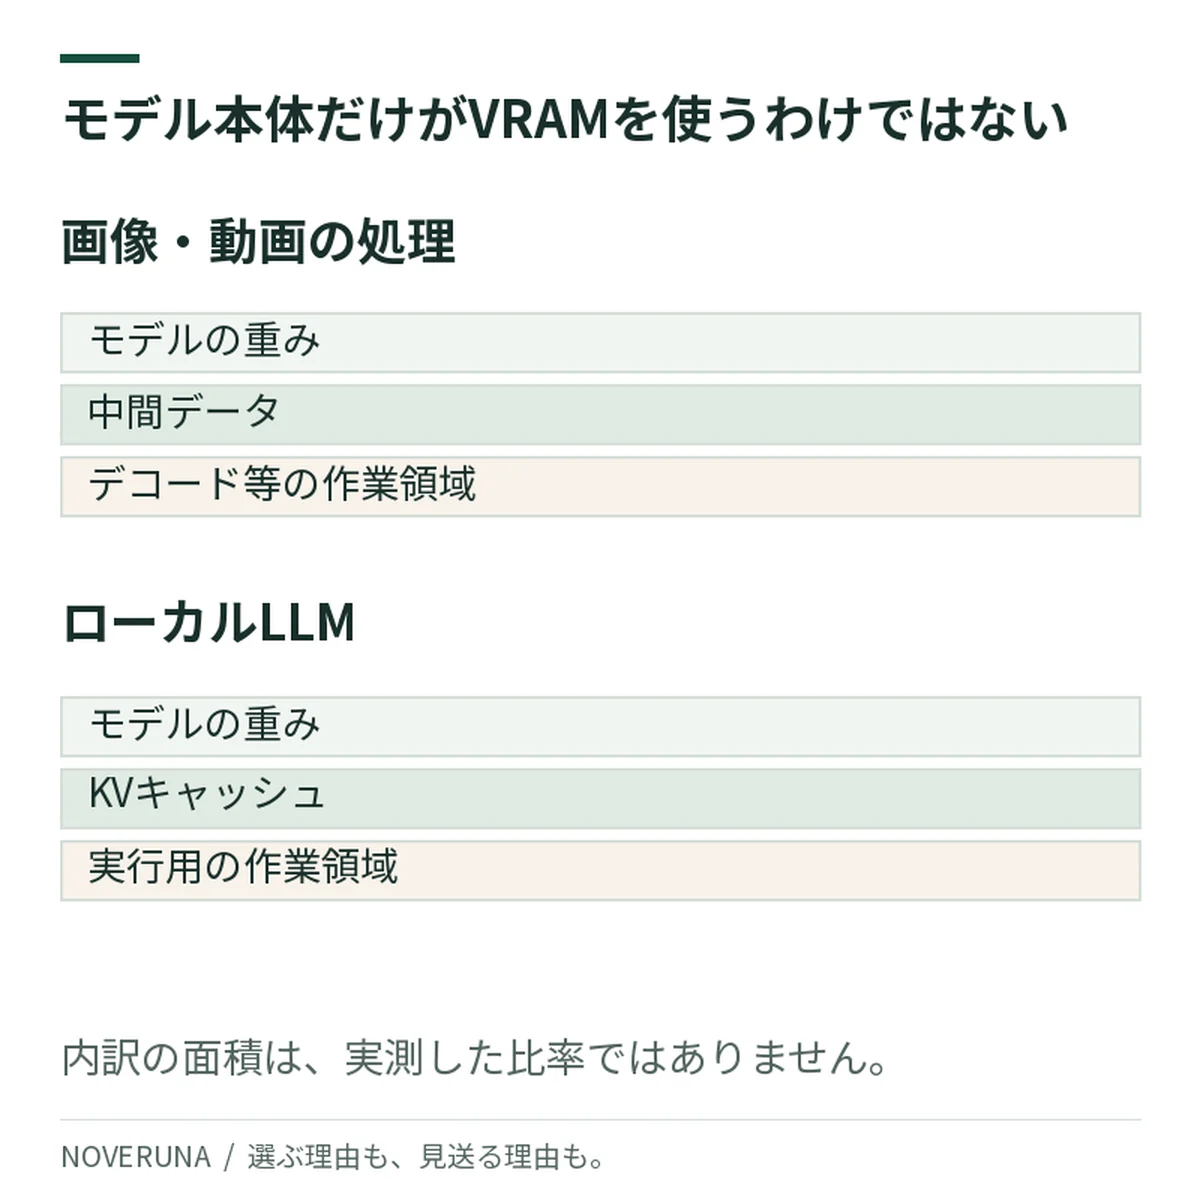
図の要点を文章で読む
- 画像・動画では、モデルの重みに加えて、中間データやデコード等の作業領域がVRAMを使います。
- ローカルLLMでは、モデルの重み、KVキャッシュ、実行用の作業領域を分けて考えます。
- 図の各領域は内訳を示したものです。大きさは実測値や容量の比率を表していません。
AI動画生成:解像度・長さ・処理の分割を一緒に見る
扱うフレームが増えると、保持する中間データも変わります。ただし必要量が動画の長さに単純比例するとは限らず、モデルや分割方式によって違います。「12GBでも起動する」と「欲しい長さの動画を現実的な時間で作れる」は別の判断です。
ローカルLLM:重み+KVキャッシュ+作業領域
量子化で重みを小さくしても、長い文脈や同時リクエストのキャッシュまで無くなるわけではありません。例えば320億パラメータを理想的な4bitで格納する計算だけなら、32×10億×4÷8=160億バイト、約14.9GiBです。これは重みだけの算術例で、量子化の付加情報、非量子化部分、KVキャッシュ、作業領域を含みません。「32Bの4bitだから16GB GPUで必ず動く」とは言えません。
画像・動画モデルの中間データとLLMのKVキャッシュは別のものです。図でも同じメモリ内訳として混ぜず、実行する処理ごとに予算を考えます。
出典・確認先:Hugging Face Diffusers:メモリ使用量を減らす、Hugging Face Transformers:KV cache戦略、ComfyUI公式リポジトリ(2026-09-11確認)。
Noverunaの判断・確認手順
まず1つ、残したい設定を固定する
- やりたい処理を1つ決める。モデル名・版、量子化、画像サイズ、動画のフレーム数、LLMの文脈長と同時実行数を記録します。
- 不足する工程を確かめる。読み込み、生成、デコード、追加処理のどこで止まるのか。OS、ドライバー、PyTorch、ComfyUIとノードの版も残します。
- 代替設定を試す。対応していれば量子化、VAEのタイル化、バッチ削減、CPUオフロードを検討。画質・使い勝手・待ち時間のどれを許容できるかを決めます。
- 候補容量で完走する証拠を探す。同じモデルと設定、同じ主要ライブラリの条件があるものを優先し、条件が違う報告をそのまま保証にしません。
オフロードは、GPUに置くデータを減らす代わりにCPUメモリや転送を使います。GPUを買わずに済む方法である一方、方式によっては大きく遅くなります。メモリ不足のエラーだけでなく、その解決に毎回どれだけ待つのかも購入判断に含めます。
一時的な大容量処理なら、条件と料金を確認した上でクラウドを必要な時間だけ使う選択もあります。機密データを外に出せない用途、継続して大量に回す用途では、ローカルの価値が変わります。ここでは未確認のクラウド料金で損益分岐点を作りません。
出典・確認先:Hugging Face Diffusers:メモリ使用量を減らす、Hugging Face Transformers:KV cache戦略(2026-09-11確認)。
Noverunaの判断・確認手順
32GBの古いGPUが、24GBの新しいGPUより速いとは限らない
VRAM容量は「どれだけ置けるか」。生成や推論の速さには、演算器、メモリ帯域、対応するデータ型、カーネル、転送、冷却による動作クロックなどが関係します。FP64の公称演算性能が高い業務用GPUでも、その強みが画像生成や量子化LLMにそのまま効くわけではありません。
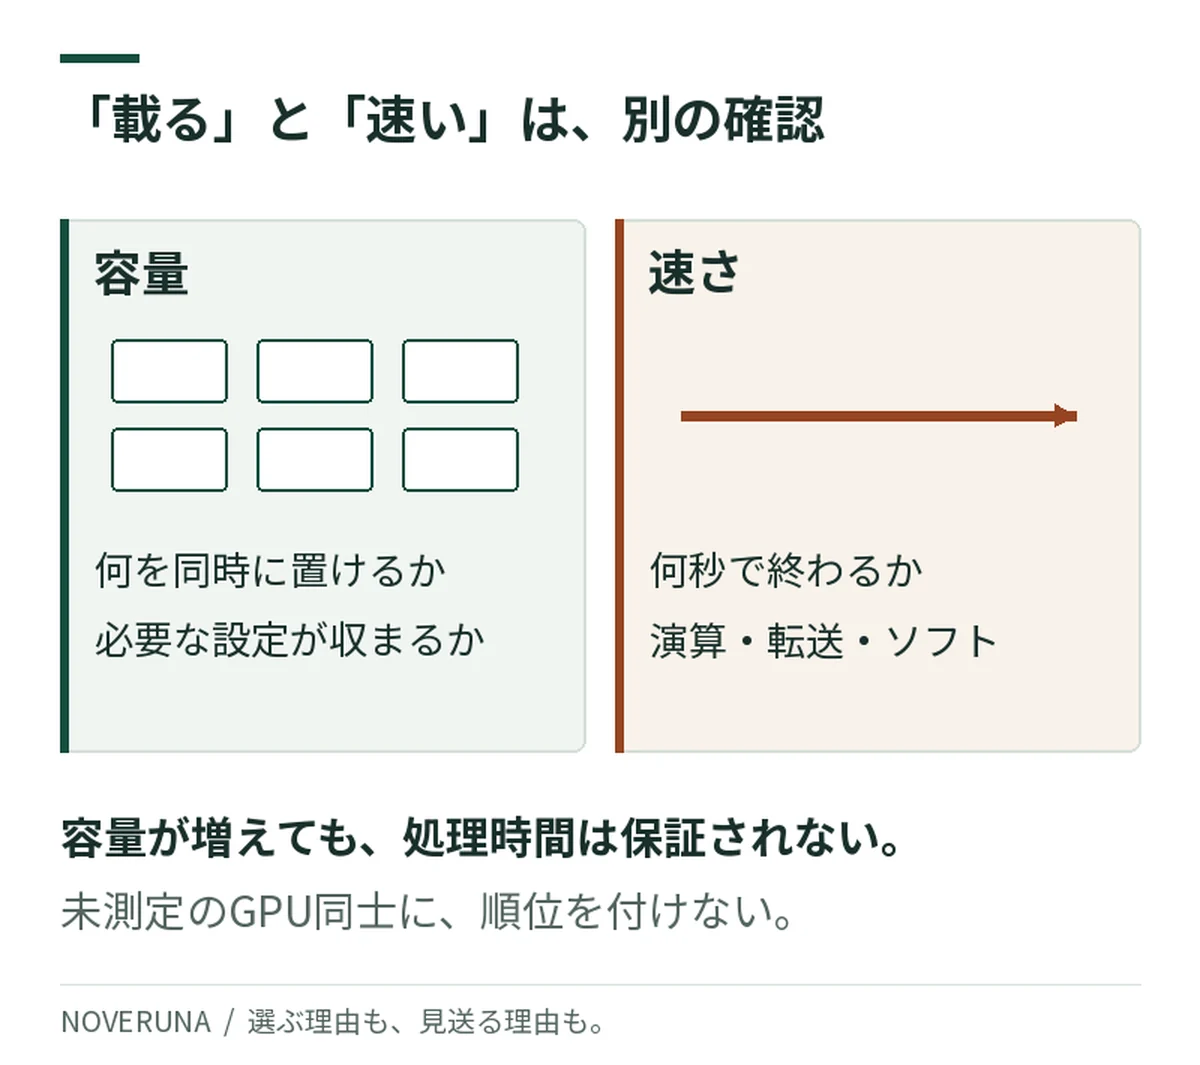
図の要点を文章で読む
- 容量の確認は、何を同時に置けるか、必要な設定が収まるかという問いです。
- 速さの確認は、演算・転送・ソフトを含めて何秒で終わるかという問いです。容量の増加だけでは処理時間を保証できません。
容量不足でCPUへ退避していた処理がGPU内に収まれば、速くなる可能性はあります。ただし、それをGPU本来の計算速度の優劣と混同しないこと。Noverunaでは未測定のV100対3090、GV100対5090の順位や生成秒数を作りません。
比較の単位は「自分の処理を、どの設定で、何秒または何分で、安定して完了できるか」です。販売ページのTFLOPS、ゲームのfps、別モデルのtokens/sは、そのまま置き換えられる数字ではありません。
Noverunaの判断・確認手順
中古業務用GPUも、ソフトと設置条件から選ぶ
32GBの候補はRTX 5090だけではありません。Tesla V100 32GB、Quadro GV100、MI50 32GB、MI60、MI100などがあります。ただし、古いGPUでは現行ソフトへの対応、サーバー用カードでは冷却や電源が購入条件になります。32GB GPUの候補記事では、この違いから比較します。
2026-09-11時点で確認した公式資料では、CUDA Toolkitの現行資料は13.4。一方でCUDA 13以降はVoltaなどCC 7.5未満を対象にした新規オフラインコンパイルを扱いません。ただし、PyTorchのCUDA 12.6系配布条件にはVoltaが残るため、「最新ソフトは一切使えない」と一括りにもできません。詳しい版とOSの境界はソフト対応の確認表にまとめています。
安価に見える製品ほど、本体以外の支出や作業も見ます。改造品はPCB移植・VRAM変更の確認項目、海外購入は日本への輸入総額、ジャンクは修理歴と再出品の確認方法へ進んでください。
出典・確認先:NVIDIA Tesla V100 Data Sheet(2018年3月)、NVIDIA:Quadro GV100発表(2018年3月27日)、AMD ROCm:GPU specifications、NVIDIA GeForce RTX 5090公式仕様、NVIDIA CUDA Toolkit 13.4 Release Notes、NVIDIA:GPUアーキテクチャのCUDAサポート方針、PyTorch公式 RELEASE.md:CUDA・OS互換表(2026-09-11確認)。
Noverunaの判断・確認手順
購入理由と、見送る理由を並べて決める
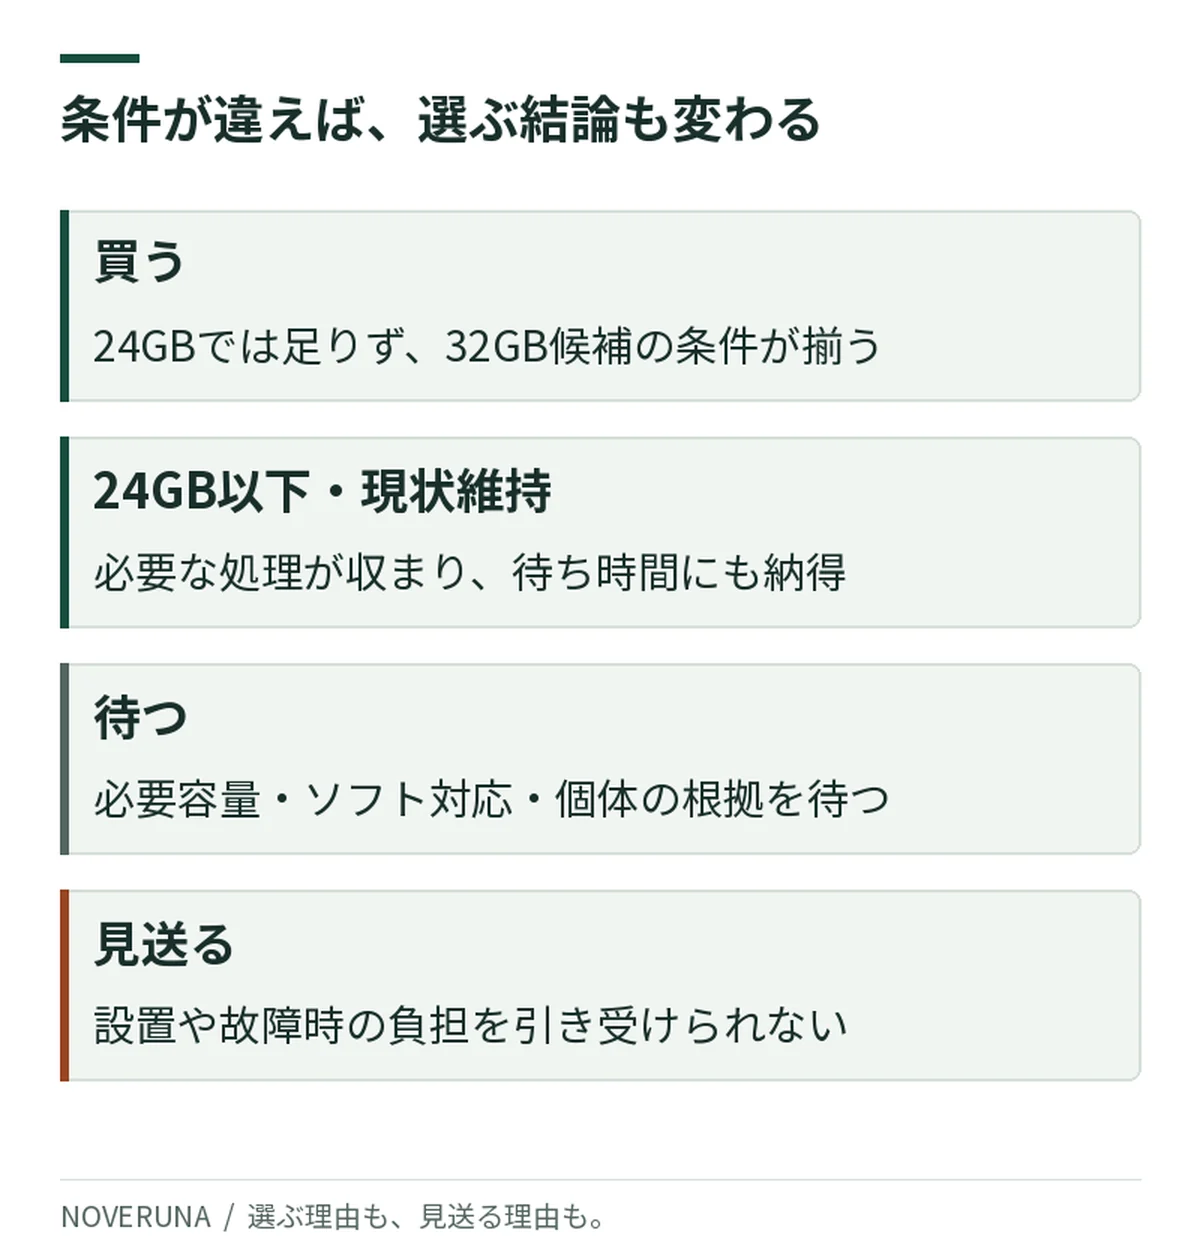
図の要点を文章で読む
- 買う:24GBでは足りず、32GB候補のソフト対応や設置などの条件が揃っている。
- 24GB以下・現状維持:必要な処理が収まり、待ち時間にも納得している。
- 待つ:必要容量、ソフト対応、購入する個体について、足りない根拠を確認する。
- 見送る:設置の条件や、故障した場合の負担を引き受けられない。
買う
必要な設定が明確で、24GBでは足りない理由があり、32GB候補のソフト対応・設置・保証まで確認できた。追加費用と停止時間を含めても、不便の解消に価値がある。
24GB以下を選ぶ・現状維持
24GB以下で目的が達成できる、または設定変更後の結果と時間に納得している。購入額の差を、保証や他の機材に振り向ける方が合う。
待つ
使いたいモデルや必要容量がまだ固まっていない。欲しいソフトの対応や、保証のある適切な個体を待つ。「いつ値下がりするか」は予測できないため、確認する条件を決めて待つ。
見送る
電源・冷却・OSの変更を受け入れられない、履歴が追えない、故障時の損失が上限を超える。安い32GBが見つかっても、解決できる課題がなければ買う理由にはしない。
VRAM不足を経験したことは、調べ始める十分な理由です。その経験を「必ず32GBを買うべき」に変えず、いま困っている工程を解消できる一台かどうかで決めます。
いまの疑問が解けたら。
次の判断に進む
- 32GBの候補と、選ばれにくい理由を比較する
V100・GV100・Instinctを、容量以外の条件から絞る。
- 業務用GPUの型番・接続・ソフトの罠を確認する
8GB×4を1GPU 32GBと取り違えないために。
- 改造GPUの仕様と責任の所在を確認する
外観の違いだけで製造元や品質を判断しない。
- 日本への輸入総額を見積もる
商品代のほかに税金・送料・手数料を含める。
- ジャンクGPUの再出品・修理歴を調べる
最悪の損失から、取れるリスクを考える。
出典と、まだ分からないこと
候補GPUの使用レビューや実測比較ではありません。公式情報と、運営者から共有された現状、Noverunaの購入判断を分けて掲載しています。
未確認事項(UNKNOWN)
- 運営者の個別ワークフローに必要なピークVRAMと、候補GPUでの処理時間は未測定。
- 今後のGPU価格、故障率、将来のライブラリ対応は未確定。
- 32GB以内であればあらゆる画像・動画・LLM処理が動くという保証はない。
出典一覧と確認範囲(11件)
- NVIDIA GeForce RTX 3090 / 3090 Ti公式仕様
24GB GDDR6X、Ampere。中古個体の状態・現行価格は別。(確認済み/2026-09-11)
- Hugging Face Diffusers:メモリ使用量を減らす
device_map、VAE slicing/tiling、CPUオフロードのメモリと転送時間のトレードオフ。ComfyUIの全ノードへの自動適用は主張しない。(確認済み/2026-09-11)
- Hugging Face Transformers:KV cache戦略
LLMのキャッシュが増加する仕組み、量子化/オフロード等。必要VRAMの実測値は引用しない。(確認済み/2026-09-11)
- ComfyUI公式リポジトリ
導入手順・対応機材の確認先。個別ワークフローの成功を保証しない。(確認済み/2026-09-11)
- NVIDIA Tesla V100 Data Sheet(2018年3月)
32GB/16GB HBM2、PCIe/SXM2、パッシブ冷却。古い製品仕様であり現行ソフト対応を示さない。(確認済み/2026-09-11)
- NVIDIA:Quadro GV100発表(2018年3月27日)
Quadro GV100の32GB、Volta。NVLinkの表現は対応アプリが必要な複数GPU構成として扱う。(確認済み/2026-09-11)
- AMD ROCm:GPU specifications
MI50の16GB/32GB別モデル、MI60/MI100 32GB、gfx906/gfx908、W7800 32GB/48GB、R9700 32GB。仕様表への掲載とサポートは別。(確認済み/2026-09-11)
- NVIDIA GeForce RTX 5090公式仕様
32GB GDDR7、公称仕様。改造品、5090D、D v2等に横展開しない。(確認済み/2026-09-11)
- NVIDIA CUDA Toolkit 13.4 Release Notes
2026-09-11取得時の現行13.4。最新Toolkit、ライブラリ、GPU対応を同一視しない。(確認済み/2026-09-11)
- NVIDIA:GPUアーキテクチャのCUDAサポート方針
CUDA13のCC7.5未満向けオフラインコンパイル削除、12.9以前の利用、R580の位置付け。(確認済み/2026-09-11)
- PyTorch公式 RELEASE.md:CUDA・OS互換表
2.14行:CUDA12.6/13.0/13.2、ROCm7.14。Linux x86/Windowsの12.6.3行にVolta、13.x行はTuring以降。カスタムノードを含む動作保証ではない。(確認済み/2026-09-11)
図解はNoverunaが制作したオリジナルの模式図です。メーカー公式写真や、候補GPUの使用・実測を示す画像ではありません。